Día 5
Objetivo del día
Probar el ejemplo de mjlab del brazo YAM con cámara y preparar mi propia copia de la tarea para poder modificarla.
Pruebas con cámara
He entrenado Mjlab-Lift-Cube-Yam-Depth: la misma tarea del cubo, pero con una cámara de profundidad de 32×32 en la muñeca. El robot ya no sabe dónde está el cubo y tiene que sacarlo de la imagen; solo el crítico, que se usa al entrenar, ve la posición exacta (crítico asimétrico).
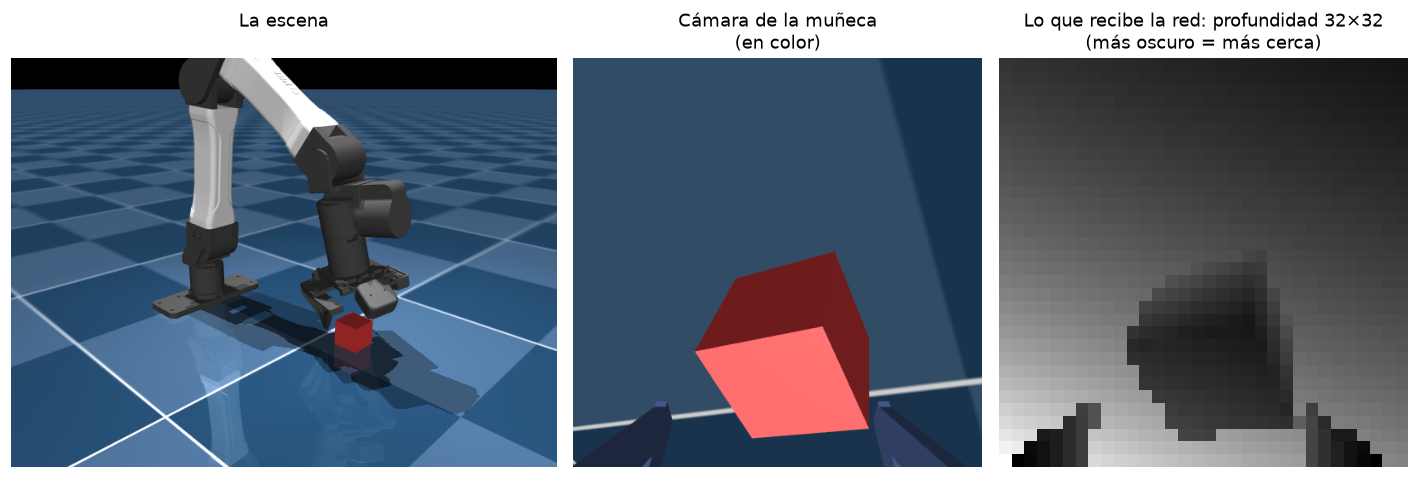
Izquierda: la escena. Centro: la cámara de la muñeca en color. Derecha: lo único que recibe la red, la profundidad de 32×32 (con el contraste aumentado para que se vea).
| Entornos | Iteraciones | Duración | Memoria GPU | Éxito |
|---|---|---|---|---|
| 256 | 3000 | 21 min | 948 MB | 0 % |
| 1024 | 1000 | 19 min | 1,9 GB | 0 % |
- Mi portátil va bien con cámara (menos de 2 GB y 68 °C como máximo), pero no aprende a coger el cubo.
- Con 4 veces más entornos pasa lo mismo, así que no es falta de experiencia.
- La exploración baja muy rápido (de 1,0 a 0,4): el robot se queda con una solución a medias y deja de probar cosas nuevas.
- A otra persona le pasa lo mismo con la versión en color: issue #1017, sin resolver.
Con el visor web (uv run play ... --viewer viser), que enseña también la imagen de la cámara, se ve que la cámara sí ve el cubo y el robot se acerca hasta ponerse delante, pero no cierra la pinza:
Tarea de ejemplo Mjlab-Lift-Cube-Yam-Depth de mjlab (licencia Apache 2.0).
Por qué creo que no lo coge
La recompensa principal (staged_position_reward) es:
recompensa = acercamiento × (1 + llevar el cubo al objetivo)
El robot cobra por acercarse, pero agarrar no le da nada hasta que el cubo ya está subiendo. Sin cámara lo acaba descubriendo porque sabe dónde está el cubo; con cámara se queda cobrando solo por acercarse.
Mi copia de la tarea
Una tarea en mjlab es una configuración dividida en apartados (observaciones, acciones, recompensas, terminaciones, objetivo, aleatorización y currículo). Lo que yo programo es eso, no el algoritmo de RL ni la física.
Para modificarla sin tocar el código de mjlab, he copiado los ficheros del YAM a mi repositorio, siguiendo el ejemplo oficial anymal_c_velocity:
src/tfg/
├── __init__.py            ← registra mis tareas (Tfg-Lift-Cube-Yam, -Depth, -Rgb...)
├── env_cfgs.py            ← la tarea adaptada al YAM y la cámara
├── rl_cfg.py              ← configuración de PPO y de las redes
└── lift_cube_env_cfg.py   ← la plantilla de la tarea (recompensas, observaciones...)
En pyproject.toml he añadido [build-system] (para que mi código se instale en el entorno) y [project.entry-points."mjlab.tasks"] (para que mjlab encuentre mis tareas). Después de uv sync, uv run list-envs ya muestra mis tareas Tfg-....
Próximos pasos
- Subir
entropy_coefpara que siga explorando más tiempo. - Añadir una recompensa por agarrar (que los dos dedos toquen el cubo).
- Si el RL puro no mejora, probar profesor-alumno.