Día 18
Objetivo del día
- Crear un dataset de imágenes de la cámara de la muñeca con el giro del cubo.
- Entrenar con aprendizaje supervisado una red pequeña que adivine el giro mirando la imagen.
- Pasarle al actor ese giro y conseguir que oriente la pinza antes de coger el cubo.
El dataset
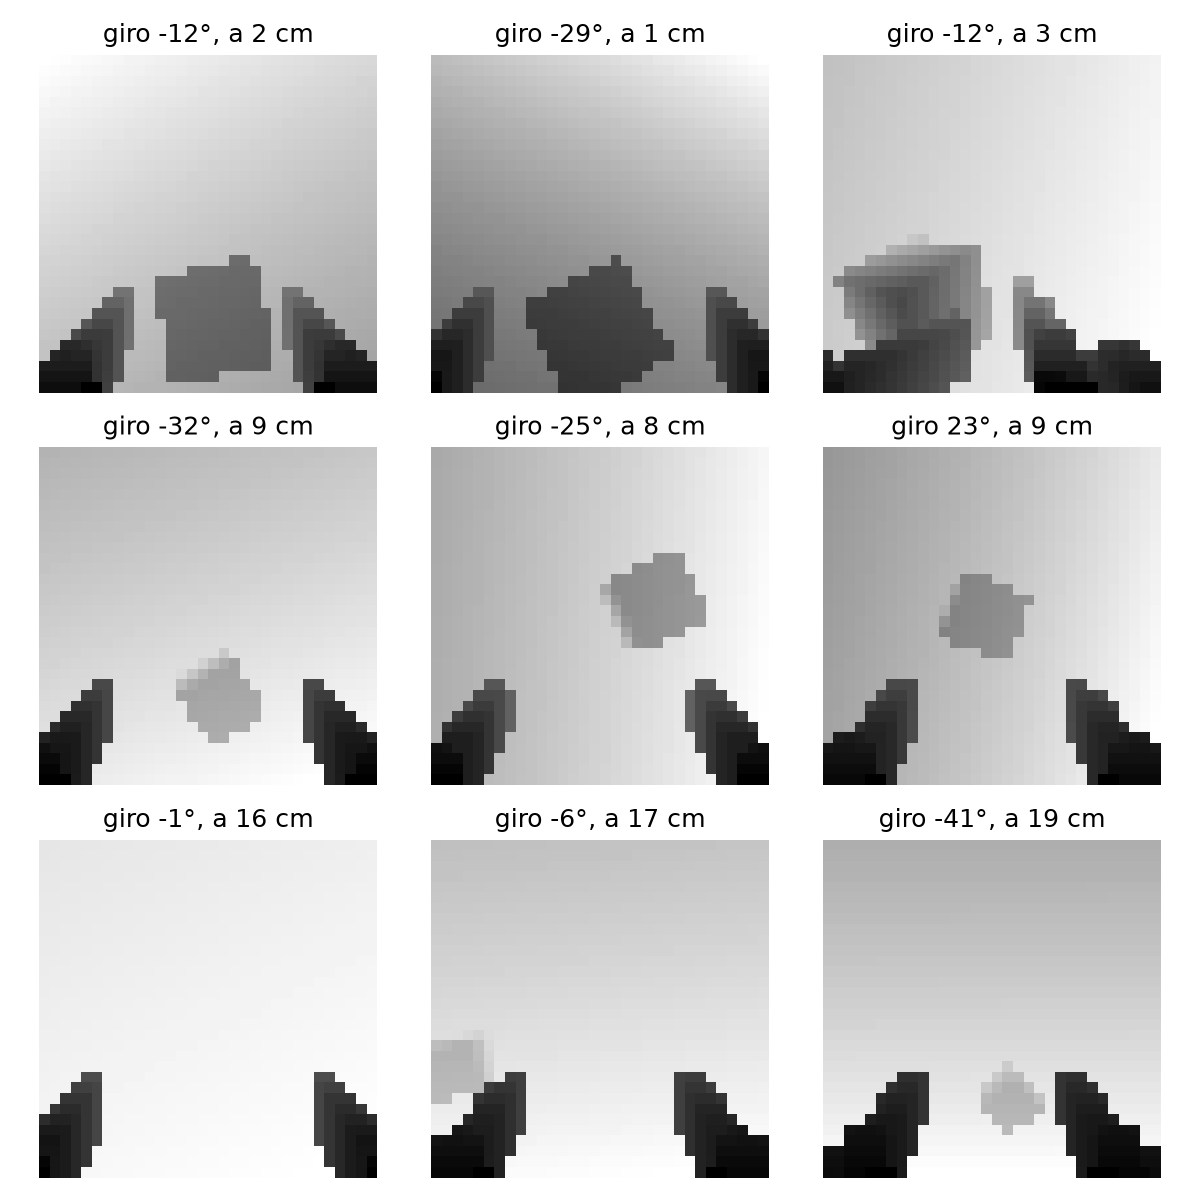
El script scripts/recoger_dataset.py mueve 1024 robots en la simulación con redes ya entrenadas y, cada 5 pasos, guarda la imagen de profundidad de 32×32 de cada robot junto con el giro exacto del cubo respecto a la pinza, que la simulación conoce. Ese giro es la etiqueta:
imagenes.append(obs["camera"][guardar].half())
giros.append(tfg_mdp.gripper_cube_yaw(env, "cube", pinza)[guardar])
distancias.append(distancia[guardar])
robots.append(numero_robot[guardar])
El giro se guarda como seno y coseno de 4 veces el ángulo:
- El cubo es igual cada 90°. Al multiplicar por 4, 90° pasa a ser 360°, que es lo mismo que 0°, así que dos giros que se ven igual dan los mismos números. Sin el 4, la red tendría que distinguir dos imágenes idénticas con etiquetas distintas.
- El coseno indica cuánto está girado el cubo (1 si está alineado, −1 si está a 45°) y el signo del seno, hacia qué lado.
De cerca (menos de 5 cm) hay muchísimas imágenes casi iguales, porque el robot pasa mucho tiempo con el cubo ya cogido, así que de esas solo se guarda 1 de cada 4.
La red de visión
La red (src/tfg/red_giro.py) está basada en el tutorial oficial de PyTorch Learn the Basics. Tiene la misma CNN que el actor, pero después usa Flatten en vez de spatial softmax:
self.convoluciones = nn.Sequential(
  nn.Conv2d(1, 16, kernel_size=5, stride=2, padding=2),
  nn.ELU(),
  nn.Conv2d(16, 32, kernel_size=3, stride=2, padding=1),
  nn.ELU(),
)
self.flatten = nn.Flatten()
self.lineales = nn.Sequential(
  nn.Linear(32 * 8 * 8, 128),
  nn.ELU(),
  nn.Linear(128, 2),  # sin y cos de 4 veces el giro
)
- El spatial softmax del actor resume cada mapa de la CNN en un punto (x, y): sirve para saber dónde está el cubo, pero pierde la forma de sus bordes.
Flattenpone todos los mapas en fila (2048 números) sin perder nada, y la capa lineal puede combinar la posición de varios bordes, que es lo que dice cómo está girado el cubo.
Se entrena en scripts/entrenar_red_giro.py:
- Es regresión (2 números), no clasificación como en el tutorial, así que la pérdida es
MSELossen vez deCrossEntropyLoss. - El test se separa por robots (1 de cada 5), no por imágenes sueltas: las imágenes seguidas de un mismo robot son casi iguales y el test saldría falsamente bueno.
- Un
WeightedRandomSamplerhace que en cada tanda haya un 40 % de imágenes de 0–5 cm, un 30 % de 5–10 cm, un 20 % de 10–20 cm y un 10 % de más lejos. La red fallaba sobre todo a 5–10 cm, justo antes de coger el cubo, y había pocas imágenes de esa distancia. - 30 épocas en vez de 15, comprobando con el test que el error seguía bajando.
La red tiene que ser robusta
La primera versión se entrenó solo con imágenes del robot del día 15, que ya sabía coger el cubo. En su test acertaba muy bien, pero al conectarla a un actor que empezaba a aprender desde cero, con las imágenes de ese robot se equivocaba mucho. Ese robot se acercaba al cubo de formas que la red no había visto nunca: descentrado, de lado, con un dedo tapando el cubo. Es un cambio de distribución.
Se recogió un segundo dataset con robots de ese entrenamiento a medio aprender, y a la mitad de ellos se les añadió ruido en las acciones para que se movieran “mal” a propósito:
acciones = politica(obs)
acciones = acciones + con_ruido * RUIDO * torch.randn_like(acciones)
Juntando los dos datasets (unas 860.000 imágenes), el error con las imágenes de ese mismo robot bajó de 10,6° a 2,1°, y con el robot final es de 1,1° cuando la pinza está cerca del cubo.
Conectar la red al actor
El actor recibe el giro que adivina la red, y el crítico, que solo se usa al entrenar, sigue recibiendo el giro exacto (actor-crítico asimétrico):
cfg.observations["actor"].terms["cube_yaw_vision"] = ObservationTermCfg(
  func=tfg_mdp.estimated_cube_yaw,
  params={"sensor_name": "camera_d405", "cutoff_distance": 0.5, "pesos": "src/tfg/red_giro.pt"},
)
estimated_cube_yaw carga la red una sola vez, porque se llama en cada paso, y la usa ya entrenada:
if _red_giro is None:
  _red_giro = RedGiro().to(env.device)
  _red_giro.load_state_dict(torch.load(pesos, map_location=env.device, weights_only=True))
  _red_giro.eval()
imagen = manipulation_mdp.camera_depth(env, sensor_name, cutoff_distance)
with torch.no_grad():
  return _red_giro(imagen)
Ver el giro no basta: tiene que compensarle
Con la red de visión y solo la recompensa del día 17 (grasp_aligned, que paga por llevar el cubo alineado en el aire), el robot acierta el giro solo el 25 % de las veces, igual que girando al azar.
Coger el cubo alineado le aportaba tan poco que el entrenamiento no lo notaba.
Se añadieron dos recompensas, encendidas con un currículo en la iteración 3000, cuando el robot ya sabe coger y llevar el cubo.
Recompensa por potencial: ir alineándose mientras se acerca
potencial = cerca * alineada
mejora = gamma * potencial - self.anterior
Solo paga si mejora: acercarse alineándose suma, alejarse o torcerse resta, y quedarse quieto no cobra nada. Así se puede volver a premiar que llegue al cubo orientado, sin que pase como en el día 17, donde se quedaba quieto encima del cubo bien orientado cobrando en cada paso. Es una recompensa por potencial (Ng, Harada y Russell, 1999).
Pero una recompensa por potencial no vale sola: lo que cobra al acercarse alineado lo devuelve poco a poco mientras lleva el cubo, así que llegar alineado no le sale más rentable. Solo sirve para guiar: en cada paso le dice si va mejor o peor, y así aprende antes hacia dónde girar.
Un premio único al tocar el cubo
Por eso se añadió un premio que sí hace que alinearse merezca la pena:
primera_vez = toca & ~self.pagado
self.pagado |= toca
return primera_vez.float() * alineada / env.step_dt
Paga una sola vez por episodio, en el instante en que los dos dedos tocan el cubo, según lo alineada que llegue la pinza (peso 20). Es la que hace que alinearse valga de verdad (alrededor del 10 % del episodio) y no se puede cobrar dos veces.
Resultados
Medido en simulación con 1024 robots:
| Sin las recompensas nuevas | Con ellas (iteración 15.000) | |
|---|---|---|
| Gira lo que necesita su cubo (±10°) | 25 % | 70 % |
| Lo coge alineado (menos de 5°) | 45 % | 66 % |
| Lo coge en diagonal (más de 20°) | 35 % | 8 % |
| Se le cae el cubo | — | 3,5 % |
Orientarse merece la pena: cogido alineado se le cae al 2,4 % de los robots, y en diagonal al 12 %.
Solo gira hacia un lado
| Giro inicial del cubo | Acierta su giro |
|---|---|
| De −5° a +45° | 93–99 % |
| De −45° a −15° | 12–36 % |
- No es la visión: la red se equivoca lo mismo hacia los dos lados.
- No es físico: sumando a la muñeca el giro que le falta, coge el cubo alineado el 86 % de las veces en vez del 24 %, y lo levanta igual.
Así que el brazo puede hacerlo, pero el actor no lo ha aprendido. La explicación más probable es que el premio al tocar era poco exigente: la nota de alineación iba de 1 (alineada) a 0 con 45° de error, y tocar el cubo 13° torcido ya cobraba el 71 % del premio. Aprender a girar hacia ese lado apenas le compensaba.
Se probó a hacer el premio más exigente, con 0 a partir de 20° de error en vez de 45°, continuando el entrenamiento desde la iteración 15.000 hasta la 18.000:
alineada = (1 - torch.minimum(diff, math.pi / 2 - diff) / math.radians(20)).clamp(min=0)
Con 13° de error pasa a cobrar el 35 % en vez del 71 %.
Resultado
Medido en simulación con 1024 robots:
| Premio con 45° (iteración 15.000) | Premio con 20° (iteración 18.000) | |
|---|---|---|
| Gira lo que necesita su cubo (±10°) | 70 % | 85 % |
| Lo coge alineado (menos de 5°) | 66 % | 77 % |
| Lo coge en diagonal (más de 20°) | 8 % | 2 % |
| Se le cae el cubo | 3,5 % | 0,8 % |
Y por cada lado:
| Giro inicial del cubo | Acierta su giro (45°) | Acierta su giro (20°) |
|---|---|---|
| De −5° a +45° | 93–99 % | 96–100 % |
| De −45° a −15° | 12–36 % | 47–80 % |
El premio más exigente hace que gire bastante más hacia el lado que no aprendía y además se le cae menos el cubo. La diferencia entre los dos lados ha bajado mucho, pero no ha desaparecido: con el cubo girado entre −45° y −35° todavía acierta solo la mitad de las veces.
También coge el cubo por arriba
Al tocar el cubo, la pinza queda unos 2,5 cm por encima de su centro: solo la yema de la punta de cada dedo toca la mitad de arriba del cubo. Pero no se le cae más por eso (los que cogen un poco más abajo pierden el cubo igual), y dejar más espacio entre los dedos y la mesa puede venir bien en el robot real. De momento se deja así y se revisará en Gazebo o en el robot real.
Próximos pasos
- Batería de pruebas con posiciones de inicio y destino.
- Exportar la red de visión para usarla en la inferencia y en Gazebo.