Semanas 1 a 3
Antes de diseñar el puente entre ROS 2 y Gymnasium, he construido a mano un caso concreto: un robot diferencial en Gazebo que aprende a ir a un objetivo, con un entorno Gymnasium escrito directamente sobre ROS 2. La idea es toparse con los problemas reales de sincronización antes de intentar generalizarlos.
Entorno de trabajo
- Ubuntu 26.04, RTX 5070 Ti, Intel Core i7 14700K
- ROS 2 Lyrical Luth.
- Gazebo Jetty (gz-sim 10.5.0), conectado a ROS mediante
ros_gz. - Gymnasium 1.4.0, Stable-Baselines3 (SB3) 2.9.2 y PyTorch 2.15, en Python 3.14. SB3 aún no declara soporte oficial para esta versión de Python, pero funciona en todas las pruebas hechas.
El problema de fondo
Gymnasium es síncrono. El algoritmo llama a reset() para empezar un episodio y después, en
bucle, a step(acción), que devuelve la observación siguiente, la recompensa y si el episodio ha
terminado. El algoritmo se queda esperando a que step() vuelva y da por hecho que lo que recibe
es la consecuencia de la acción que acaba de enviar.
ROS 2, en cambio, es asíncrono. Gazebo publica la odometría a su ritmo, la orden de velocidad llega cuando llega y nadie espera a nadie. El entorno tiene que convertir ese flujo asíncrono en una función síncrona, y hay dos maneras de hacerlo:
| Tiempo real | Por pasos | |
|---|---|---|
| Funcionamiento | Gazebo corre libre; cada step() publica la acción, espera 0,1 s de reloj y lee la última observación |
Gazebo está en pausa y solo avanza cuando el entorno se lo pide |
| Duración de un paso | Varía con la carga de la máquina | Siempre 0,1 s simulados |
| Mientras la red decide | El robot sigue moviéndose con la orden anterior | El mundo está parado |
| Reproducible con la misma semilla | No | Sí |
| Más rápido que el tiempo real | No | Sí |
| Robot real | Es la única opción | No es posible: el mundo real no se pausa |
Este primer entorno implementa el modo por pasos. El de tiempo real vendrá después, para comparar los dos con datos.
La tarea
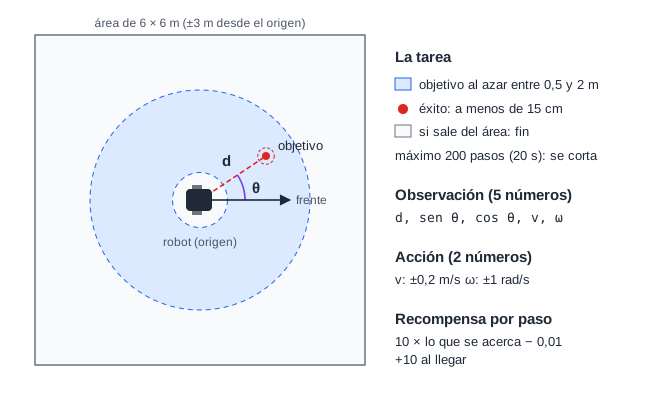
El robot empieza en el origen y en cada episodio aparece un objetivo al azar entre 0,5 y 2 m. El episodio termina con éxito si el robot llega a menos de 15 cm, termina con fracaso si se sale del área de 6 × 6 m y se corta a los 200 pasos (20 s).
Gymnasium distingue esos finales: llegar o salirse es un final de verdad (terminated), mientras
que el corte es solo un límite de tiempo (truncated). No es un detalle formal. El algoritmo usa
el final para estimar cuánto vale cada situación, y si el corte se tratara como un final de
verdad, aprendería que en el paso 200 ya no se puede ganar nada aunque el robot esté a punto de
llegar.
Acción, observación y recompensa
La acción son dos números entre −1 y 1, que el entorno escala a velocidad lineal (±0,2 m/s) y
angular (±1 rad/s). La observación son cinco números calculados a partir de la odometría: la
distancia al objetivo d, el seno y el coseno del ángulo θ hacia él, y las dos velocidades
medidas.
Se usa la odometría, y no la posición exacta que conoce Gazebo, porque es lo que tendrá un robot real. Se desvía algo (unos 3,5 cm en un arco de 3 s), pero en esta tarea no molesta.
El objetivo se expresa relativo al robot porque lo que debe hacer (girar, avanzar) depende de dónde está el objetivo respecto a él, no de en qué punto del mundo se encuentre. Y el ángulo entra como seno y coseno porque un ángulo salta de +180° a −180° cuando el objetivo pasa por detrás: dos números muy distintos para dos situaciones casi iguales, algo que a una red le cuesta aprender.
La recompensa de cada paso suma 10 por cada metro que el robot se acerca al objetivo, resta 0,01 y añade 10 al llegar. El término de acercamiento da una pista en cada paso; con solo el bonus final, el robot no recibiría ninguna señal hasta llegar por casualidad. La pequeña penalización evita que quedarse quieto salga gratis.
Comprobación de las decisiones de diseño
Para ver si estas decisiones importan, entrené dos variantes cambiando una sola cosa cada vez: sin el término de acercamiento y con el ángulo en bruto.
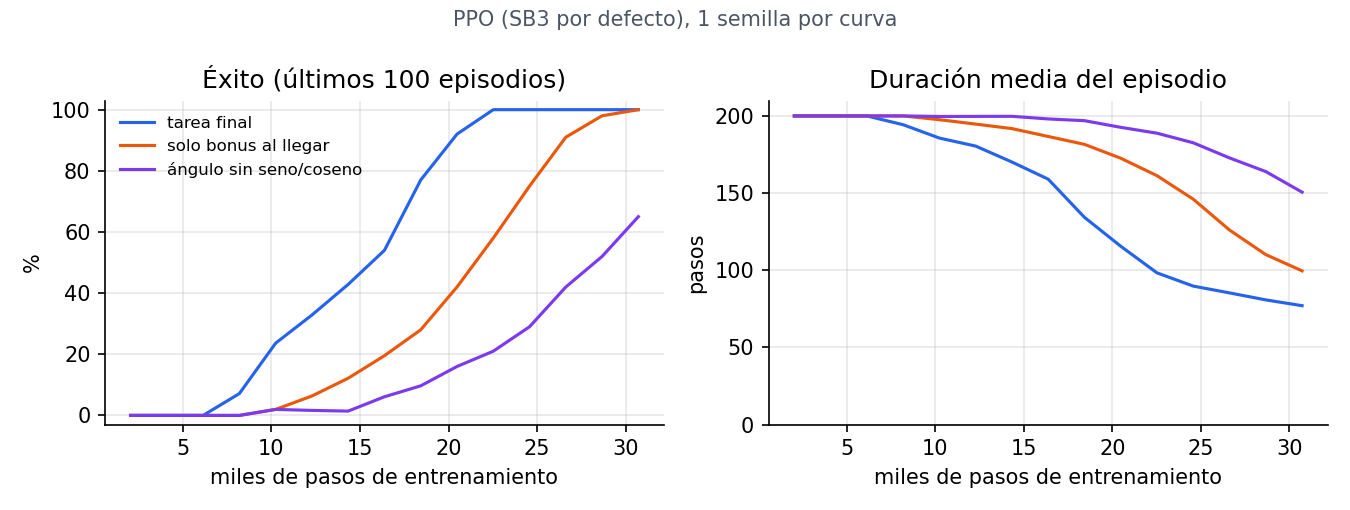
| Variante | Éxito |
|---|---|
| Tarea final | 92 % a los 20 500 pasos; 100 % desde los 22 500 |
| Sin término de acercamiento | 91 % a los 26 600 pasos, con trayectorias un 30 % más largas a los 30 000 |
| Ángulo en bruto | 65 % a los 30 000 pasos |
Con una semilla por curva no es un resultado concluyente, pero apunta a que la representación de la observación pesa más que la forma de la recompensa.
Arquitectura
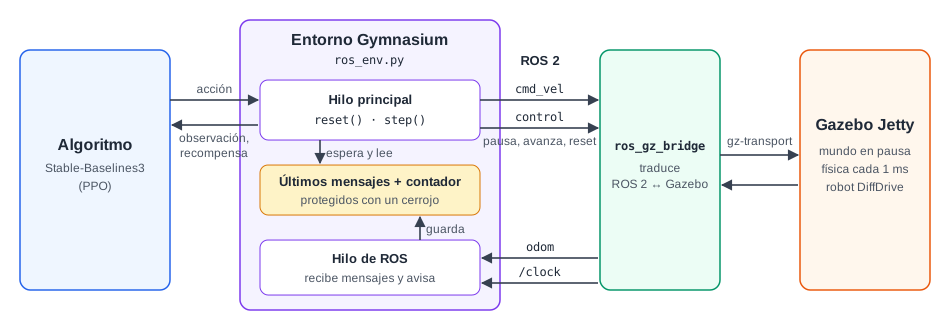
Todo está en un paquete de ROS 2, goal_reaching:
| Fichero | Contenido |
|---|---|
urdf/diff_drive_robot.urdf |
El robot: chasis, dos ruedas y una rueda loca, con el plugin DiffDrive de Gazebo, que recibe la velocidad y publica la odometría a 50 Hz |
worlds/goal_reaching.sdf |
El mundo: suelo, luz y física con un paso de 1 ms. Incluye el robot |
launch/sim.launch.py |
Arranca Gazebo (sin interfaz gráfica, en pausa y sin límite de velocidad), robot_state_publisher, ros_gz_bridge y, opcionalmente, RViz |
config/bridge.yaml |
Qué traduce ros_gz_bridge: cmd_vel hacia Gazebo; odom, tf, joint_states y /clock hacia ROS; y el servicio de control del mundo |
task.py |
La tarea: objetivo, observación, recompensa y condiciones de fin. No depende de ROS |
ros_env.py |
El entorno Gymnasium: reset(), step() y la sincronización con Gazebo |
Control del tiempo de la simulación
Gazebo ofrece un servicio de control del mundo que permite pausarlo, avanzar un número exacto de
iteraciones de física y reiniciarlo. ros_gz_bridge lo expone en ROS 2. El entorno mantiene el mundo
siempre en pausa, y cada step() pide avanzar 100 iteraciones de 1 ms, es decir, exactamente
0,1 s simulados. El tiempo que cuenta es el de la simulación, que Gazebo publica en /clock.
Ir por pasos solo es más rápido que el tiempo real si se quita el límite de velocidad de Gazebo (el real time factor). Con el límite puesto, simular 0,1 s cuesta 0,1 s de reloj:
| Límite de velocidad de Gazebo | Tiempo de reloj por paso de 0,1 s |
|---|---|
| Tiempo real (factor 1) | ~101 ms |
| Sin límite (factor 0) | ~8–11 ms |
Los 0,1 s se eligieron múltiplo del periodo de la odometría (20 ms), de modo que al final de cada paso Gazebo publica una odometría con la marca de tiempo exacta del final. Con un paso de 0,11 s, la última odometría sería de 10 ms antes y la observación llegaría desfasada. Por la misma razón, el entorno da error si el paso de física no divide exactamente el periodo de control.
Anatomía de un paso
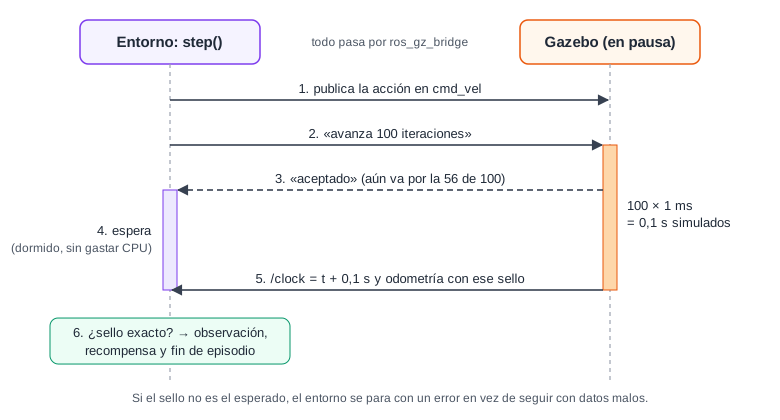
El punto delicado es el paso 3: el servicio de control responde antes de que Gazebo termine. En una medida, cuando llegó la respuesta, Gazebo iba por la iteración 56 de 100. La respuesta solo confirma que la petición se ha recibido; leer la odometría en ese momento daría la de mitad del paso, y la observación y la recompensa no corresponderían a la acción.
Por eso el entorno espera a la odometría cuya marca de tiempo coincide con el final del paso. Es más fiable que esperar un tiempo fijo, que unas veces se quedaría corto y otras desperdiciaría tiempo.
Si llega una odometría con otra marca, el entorno se detiene con un error. Es la red de seguridad del diseño, porque un error de sincronización no detectado no hace fallar nada: el agente simplemente aprende peor y no se sabe por qué. Al quitar a propósito dos piezas de la sincronización, la espera del reloj en cero y el contador de mensajes (ambas explicadas más abajo), fue esta comprobación la que detuvo el entorno.
Si un paso falla a mitad, el entorno exige un reset() antes de aceptar otro step(), para no
continuar desde un estado desconocido.
Dos hilos
Mientras step() espera la odometría, alguien tiene que estar recibiendo los mensajes de ROS.
Con un solo hilo, step() esperaría un mensaje que nadie va a recoger. Por eso el entorno usa
dos: el hilo principal, que es el de SB3 y ejecuta reset() y step(), y el hilo de
ROS, que solo recibe mensajes. Cada vez que llega uno, el hilo de ROS lo guarda en una zona de
memoria compartida, incrementa un contador para ese topic y avisa.
La zona compartida está protegida con un cerrojo, para que los dos hilos nunca la modifiquen a la vez. El hilo principal no comprueba cada pocos milisegundos si ha llegado algo: se queda dormido, sin consumir CPU, hasta que el hilo de ROS lo despierta. Comprobar, dormirse y despertar van bajo el mismo cerrojo; si no, un aviso podría llegar justo entre “aún no ha llegado” y “me duermo”, y el hilo principal se quedaría esperando un mensaje que ya tiene.
Una alternativa habría sido que el propio step() atendiera a ROS mientras espera. Funciona, pero
entre un paso y el siguiente nadie recibiría los mensajes. Con un hilo dedicado, ROS está siempre
atendido.
Dos detalles de este diseño salieron de errores reales. El primero es el contador: tras un reset, el último mensaje guardado es del episodio anterior y tiene una marca de tiempo mayor, así que una espera del tipo “odometría con marca ≥ t” se cumplía al instante con ese mensaje viejo. Ahora el entorno anota el contador antes de enviar la petición y solo acepta mensajes recibidos después. El orden importa: si lo anotara después, la respuesta podría llegar entre medias y contarse como vieja.
La figura sigue a los dos hilos durante el primer avance tras un reset, que es justo el caso en el que el contador importa:
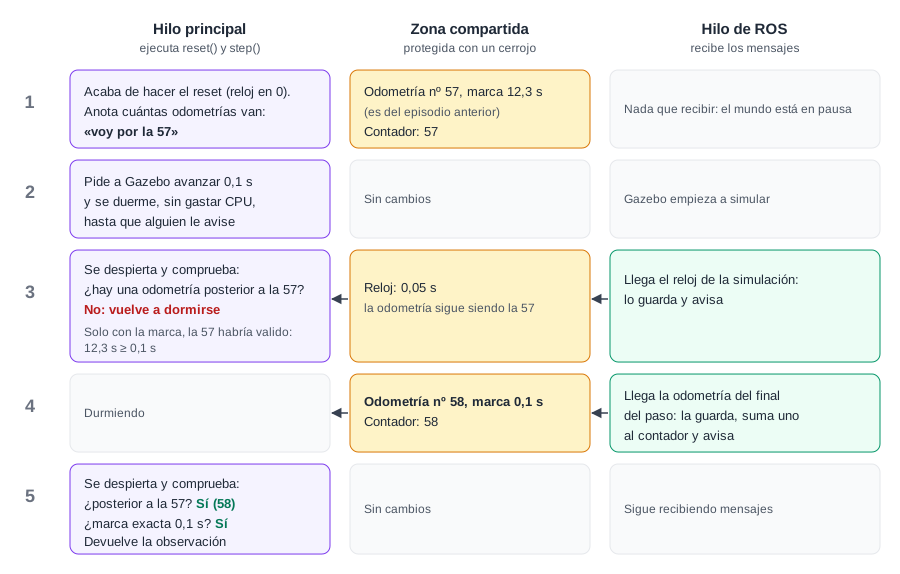
En el momento 3, el reloj despierta al hilo principal aunque lo que espera es una odometría. No es un problema: comprueba, ve que aún no ha llegado y vuelve a dormirse. Lo que no puede pasar es lo contrario, que se despierte con la odometría vieja y la dé por buena.
El segundo es que nunca se espera dentro del hilo de ROS. Las funciones que reciben los mensajes tienen que volver enseguida; si una se pusiera a esperar otro mensaje, el hilo de ROS se pararía y no llegaría nada más. Al probarlo, todo quedó congelado hasta el tiempo límite.
Por último, cada entorno crea su propio contexto de ROS en vez de usar el global, de modo que puede haber varios en el mismo proceso (SB3 puede crearlos para entrenar en paralelo) sin que cerrar uno apague los demás. El cierre sigue un orden fijo: apagar ROS, esperar a que termine su hilo y destruir el nodo. Un programa que termina sin cerrar el entorno, por ejemplo por una excepción, acaba con un fallo de segmentación.
Reset
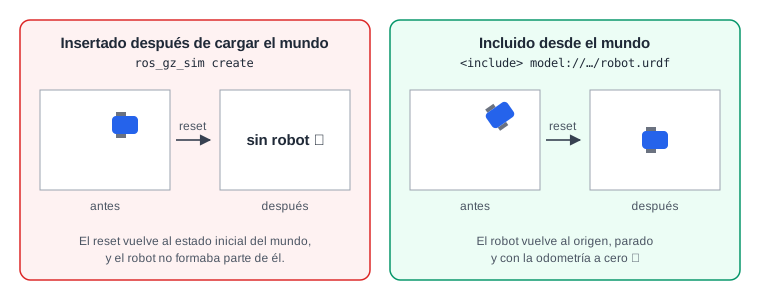
El reset del mundo devuelve Gazebo al estado que tenía al cargar el fichero del mundo. Al principio, el robot se insertaba desde ROS después de cargar el mundo, así que no formaba parte de ese estado y desaparecía con cada reset. Manteniendo el robot en URDF, se compararon dos soluciones, con 20 resets de cada una y el límite de tiempo real puesto:
| Opción | Primera odometría tras el reset | Fiabilidad |
|---|---|---|
| Volver a insertar el robot tras cada reset | ~107 ms | Si se inserta justo después del reset, responde con éxito pero el robot no aparece; hay que esperar unos 50 ms a ciegas |
| Incluir el URDF desde el propio mundo (elegida) | ~105 ms | El robot vuelve siempre al origen, parado y con la odometría a cero |
Las dos tardan lo mismo, así que decide la fiabilidad: una espera a ciegas que hoy basta podría no bastar en una máquina más cargada.
El reset() del entorno hace tres cosas, y cada una responde a un comportamiento de Gazebo que no
era el esperado:
- Pide pausa y reset en la misma petición, porque el reset quita la pausa y, pidiendo solo el reset, el mundo volvería a cero y seguiría corriendo.
- Espera a que el reloj de la simulación marque cero. Una petición de control que llega antes de que Gazebo aplique la anterior la sustituye: un reset seguido al instante de un paso perdía el reset, y el reloj pasaba de 0,5 a 0,6 s sin volver a cero. Gazebo aplica el reset en unos 2,4 ms, así que la espera apenas cuesta.
- Avanza un paso para obtener la primera observación, porque con el mundo en pausa Gazebo no publica odometría (0 mensajes en 1 s).
El primer reset tras arrancar Gazebo tiene además un caso especial. El servicio de control ya
responde, pero ros_gz_bridge todavía no reenvía la odometría, así que la del primer paso se pierde y,
con el mundo en pausa, no llega otra. Si en 1 s no ha llegado, el entorno repite el reset
completo; en tres arranques hicieron falta 2, 2 y 1 intentos.
Otras decisiones
La tarea está separada de ROS. task.py recibe números y devuelve números. Eso permite
probarla sin simulador (43 tests en medio segundo) y reutilizarla sin cambios en el modo de tiempo
real y en un entorno con Gazebo sin ROS. Si cada modo tuviera su propia copia, cualquier
diferencia accidental entre copias invalidaría la comparación.
Gazebo se arranca sin shell. El launch que trae ros_gz_sim arranca Gazebo dentro de una
shell, y al cerrar el launch desde un programa, como hacen los tests, la señal solo le llega a la
shell: Gazebo sigue vivo y la siguiente simulación del mismo mundo convive con él. Nuestro launch
arranca gz sim directamente, y al cerrarse se cierra todo.
Los namespaces no bastan para aislar simulaciones. Los nombres de ros_gz_bridge son
relativos para poder meter cada simulación en su namespace, pero al probar dos simulaciones con namespaces
distintos, la segunda no llegó a simular (Gazebo no admite dos mundos con el mismo nombre en la
misma partición) y el reloj llegaba duplicado. Para ejecutar varias en paralelo hacen falta
también GZ_PARTITION y ROS_DOMAIN_ID distintos.
Hubo también dos problemas menores con el URDF. Pasarlo a robot_state_publisher por línea de
comandos falla porque el valor se interpreta como YAML, y se resolvió con un launch en Python. Y
la fricción de la rueda loca se perdía sin aviso, porque al convertir el URDF los enlaces unidos
por una articulación fija se fusionan; se resolvió dándole a la rueda loca su propio enlace.
Validación y resultados
El entorno pasa los comprobadores de entornos de Gymnasium y de SB3, que verifican el contrato:
espacios, firmas de reset() y step(), tipos de datos y reproducibilidad con la misma semilla.
Además tiene 43 tests unitarios, que no necesitan simulador, y 3 de integración, que arrancan la
simulación completa con el launch, ejecutan pasos y resets reales y la apagan al terminar. Los de
integración destaparon el problema del primer reset y el de Gazebo sobreviviendo al launch, que a
mano no aparecían.
En velocidad, un step() completo cuesta 11,7 ms de mediana (p95 13,0 ms, sobre 1262 pasos):
unos 85 pasos por segundo, 8,5 veces más rápido que el tiempo real.
Como prueba de que todo encaja, entrené PPO con la configuración por defecto de SB3, en CPU, durante 50 000 pasos (637 s):
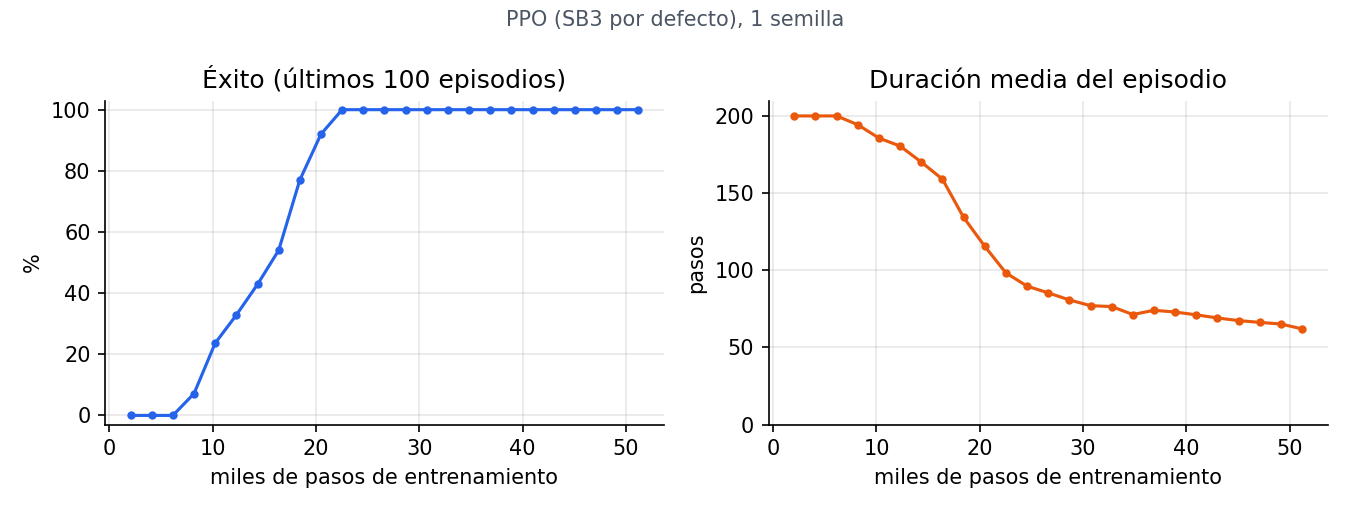
El éxito pasa del 0 % al 100 % hacia los 22 500 pasos, y la duración de los episodios sigue bajando después porque la política aprende caminos más cortos. En una evaluación con 20 objetivos nuevos llega a los 20, en 62 pasos de media (1,21 veces el mínimo en línea recta); una política aleatoria no llega a ninguno. Es una sola semilla, así que todavía no es un resultado, pero confirma que la tarea y la sincronización están bien planteadas.
El vídeo muestra la política entrenada en Gazebo, en tiempo real. La esfera roja es el objetivo, con el radio de éxito (15 cm). Tras cada llegada, el mundo se reinicia y aparece un objetivo nuevo:
Limitaciones conocidas
- El primer paso tras cada reset tarda 100 o 200 ms más que el resto, sin causa encontrada. Supone entre un 6 y un 12 % del tiempo de un episodio.
- Nada garantiza que la orden de velocidad llegue a Gazebo antes de que empiece el paso, porque
viaja por un camino de
ros_gz_bridgedistinto al del servicio de control. En 40 pruebas llegó siempre a tiempo.