Week 104 - Entrenamiento FastViT
Modelo y configuración del entrenamiento
Como línea base para la comparación posterior con los diferentes métodos de enriquecimiento de datos, se entrenó un modelo FastViT-SA12 utilizando exclusivamente el dataset Burbuja, compuesto por aproximadamente 60.000 muestras provenientes de 11 recorridos (runs).
El experimento fue identificado como:
fastvit_sa12_burbuja_60k_reg_bal_v4
La arquitectura FastViT-SA12 fue implementada mediante timm e inicializada sin pesos preentrenados (pretrained=False). La cabeza de clasificación original del modelo fue sustituida por una capa lineal de dos salidas continuas, correspondientes a las variables de control:
steer: comando de dirección.throttle: comando de aceleración.
Por tanto, la salida del modelo tiene la forma:
[steer, throttle]
La modificación de la cabeza se realizó mediante:
num_ftrs = model.head.fc.in_features
model.head.fc = nn.Linear(num_ftrs, 2)
De esta manera, FastViT-SA12 se utiliza como modelo de regresión para conducción autónoma en lugar de como clasificador de imágenes.
Las imágenes utilizadas provienen de la cámara de segmentación semántica de CARLA. A partir de cada imagen se extrae únicamente la clase correspondiente a la carretera (road), obteniendo una máscara binaria. El procesamiento aplicado es:
Segmentación CARLA → extracción de road → crop → resize 224×224 → máscara binaria → 3 canales
La máscara se normaliza al rango [0,1] y se replica en tres canales, obteniendo una entrada de tamaño 3 × 224 × 224.
No se aplicaron rotaciones, traslaciones ni flip horizontal durante este experimento, con el objetivo de conservar la relación geométrica entre la posición de la carretera y el valor de steer.
La configuración principal del entrenamiento fue:
| Parámetro | Valor |
|---|---|
| Arquitectura | FastViT-SA12 |
| Dataset | Burbuja 60k |
| Pretrained | No |
| Entrada | 224 × 224 × 3 |
| Salidas | steer, throttle |
| Batch size | 64 |
| Épocas máximas | 30 |
| Learning rate | 1e-4 |
| Optimizador | AdamW |
| Weight decay | 0.08 |
| Warm-up | 5 épocas |
| Scheduler | Warm-up lineal + Cosine Annealing |
| Drop path | 0.20 |
| Mixed Precision (AMP) | Sí |
| Gradient clipping | 5.0 |
| Early stopping | 8 épocas |
| Función de pérdida | Smooth L1 |
| Peso steer | 1.5 |
| Peso throttle | 1.2 |
| Smooth L1 beta | 0.05 |
Para evitar fuga de información entre imágenes consecutivas, el conjunto se dividió por recorridos completos y no por frames individuales. De los 11 runs disponibles, se utilizaron 9 para entrenamiento y 2 para validación.
También se realizó un balanceo de las muestras según la magnitud del steer, utilizando la siguiente distribución objetivo:
| Condición | Distribución objetivo |
|---|---|
| Giro fuerte izquierda | 15 % |
| Giro moderado izquierda | 20 % |
| Recta | 30 % |
| Giro moderado derecha | 20 % |
| Giro fuerte derecha | 15 % |
El balanceo considera adicionalmente cuatro intervalos de throttle, formando 20 clases combinadas steer × throttle.
Resultados del entrenamiento
El entrenamiento finalizó mediante early stopping en la época 16. Los mejores resultados de validación fueron:
| Métrica | Resultado | Época |
|---|---|---|
| Mejor pérdida total | 0.317248 | 3 |
| Mejor MAE de steer | 0.053772 | 8 |
| Mejor MAE de throttle | 0.240016 | 1 |
Para las pruebas de conducción se utilizó principalmente el checkpoint best_steer_model.pth, correspondiente al menor error de dirección en validación.
Los resultados muestran una diferencia importante entre las dos variables de control. El steer continúa mejorando durante las primeras épocas, mientras que el mejor resultado de throttle aparece desde la primera época y posteriormente no mejora en validación. Esto indica una capacidad limitada del modelo para generalizar la aceleración a partir únicamente de la máscara binaria de carretera.
Evaluación offline
El modelo se evaluó sobre 10.797 muestras no utilizadas para el entrenamiento. Los principales resultados fueron:
| Variable | MAE | RMSE |
|---|---|---|
| Steer | 0.0538 | 0.0931 |
| Throttle | 0.2493 | 0.3122 |
El resultado global de steer es razonable; sin embargo, al separar las muestras según la intensidad de la curva se observa una diferencia importante:
| Condición | Muestras | MAE steer |
|---|---|---|
Recta (|steer| ≤ 0.04) |
7.239 (67.0 %) | 0.0331 |
Curva media (0.04 < |steer| ≤ 0.14) |
2.161 (20.0 %) | 0.0565 |
Curva fuerte (|steer| > 0.14) |
1.397 (12.9 %) | 0.1567 |
Por tanto, el error de dirección en curvas fuertes es aproximadamente cinco veces mayor que en conducción recta. Esto permite explicar por qué un MAE global relativamente bajo no se traduce necesariamente en una conducción completamente robusta en lazo cerrado.
También se observa que la desviación estándar de las predicciones de steer (0.106) es menor que la de las etiquetas reales (0.126), lo que sugiere cierta tendencia del modelo a suavizar las correcciones de mayor magnitud.
El comportamiento del throttle es menos satisfactorio. El MAE obtenido fue de aproximadamente 0.25, con un RMSE de 0.31. Además, la variabilidad de las predicciones (std ≈ 0.160) es considerablemente menor que la de los valores reales (std ≈ 0.288), mostrando una tendencia a concentrar la salida en valores intermedios.
Debido a este comportamiento, durante las pruebas online fue necesario restringir la salida de throttle, utilizando valores máximos del orden de 0.5–0.6, con el fin de evitar aceleraciones excesivas y poder evaluar con mayor claridad el desempeño del modelo en dirección.
Evaluación online en CARLA
Las pruebas online se realizaron en CARLA utilizando la misma geometría de cámara empleada durante la generación del dataset: cámara de segmentación semántica ubicada en x=1.3 m, y=0 m, z=1.5 m, orientación (0°,0°,0°), FOV de 90° y resolución original de 800 × 600.
La política se ejecutó a 10 Hz. Durante las pruebas se visualizaron en tiempo real la segmentación recibida por el modelo, las predicciones de steer y throttle, los comandos aplicados al vehículo y el tiempo de inferencia.
En términos cualitativos, el vehículo logra navegar correctamente la mayor parte del circuito, manteniéndose sobre la trayectoria y superando numerosas curvas. Sin embargo, el comportamiento todavía no es completamente robusto. En determinadas curvas la corrección de steer resulta insuficiente y, especialmente durante la salida de algunas de ellas, el vehículo puede abandonar la trayectoria e impactar contra elementos del entorno, como postes.
Este comportamiento es consistente con el análisis offline, donde las curvas fuertes presentan un MAE de steer considerablemente mayor que las rectas. Por tanto, el principal problema del modelo Burbuja no se encuentra en la conducción nominal, sino en su capacidad para responder ante situaciones que requieren correcciones de dirección de mayor magnitud.
El tiempo medio de inferencia del modelo fue de aproximadamente 5.2 ms, mientras que el pipeline completo de procesamiento e inferencia requirió alrededor de 13.6 ms por imagen, por lo que el tiempo de cómputo no constituye actualmente una limitación para una política ejecutada a 10 Hz.
Estos resultados se utilizarán como línea base del dataset Burbuja. Los siguientes experimentos mantendrán la misma arquitectura y protocolo de evaluación, modificando principalmente la composición del dataset mediante estrategias de enriquecimiento y mezcla, con el objetivo de determinar si estas permiten mejorar la robustez frente a curvas y situaciones de recuperación.
Evaluación offline del modelo FastViT-SA12
Para facilitar la interpretación visual, las comparaciones entre los valores reales y predichos se muestran sobre una ventana de 200 muestras consecutivas. Las métricas y los histogramas de error se calcularon utilizando la totalidad del conjunto de validación.
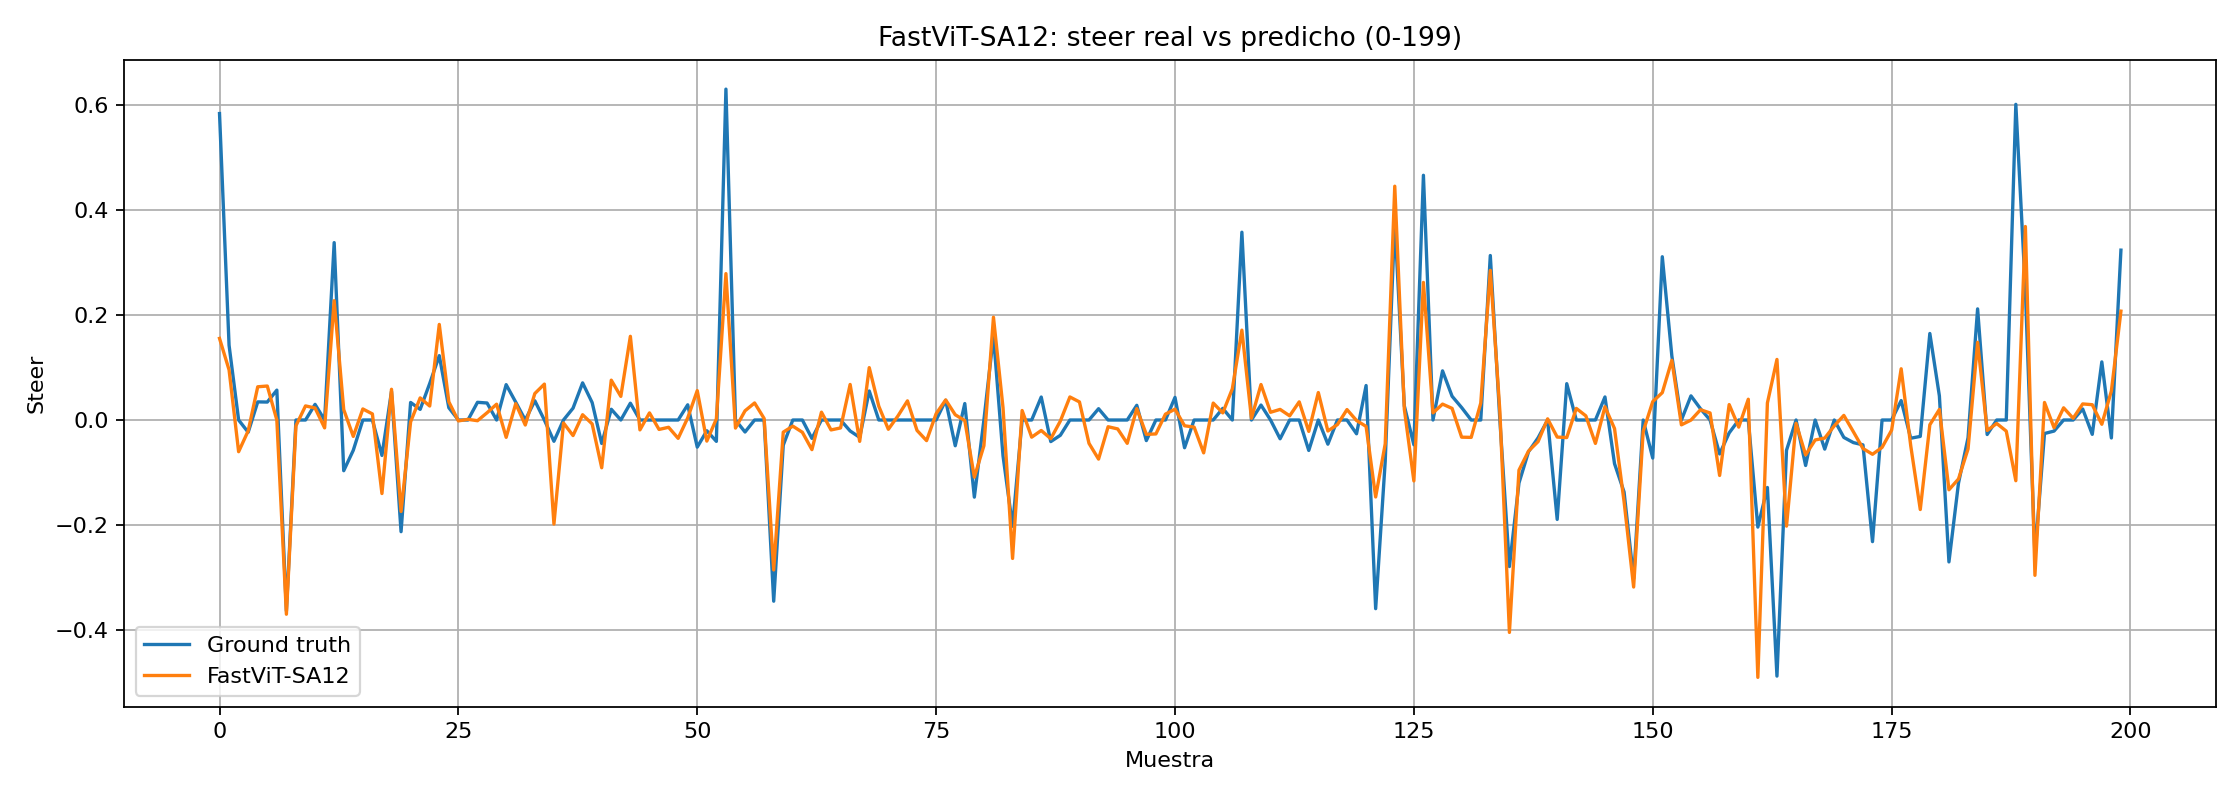
En la comparación del steer se observa que FastViT-SA12 reproduce adecuadamente la tendencia general de la dirección y el signo de muchas de las correcciones. Sin embargo, el modelo tiende a suavizar algunos valores extremos, especialmente cuando se requieren giros de mayor magnitud. Este comportamiento es consistente con las pruebas online, donde la mayor parte del recorrido se completa correctamente, pero algunas curvas requieren una corrección más intensa de la que el modelo genera.
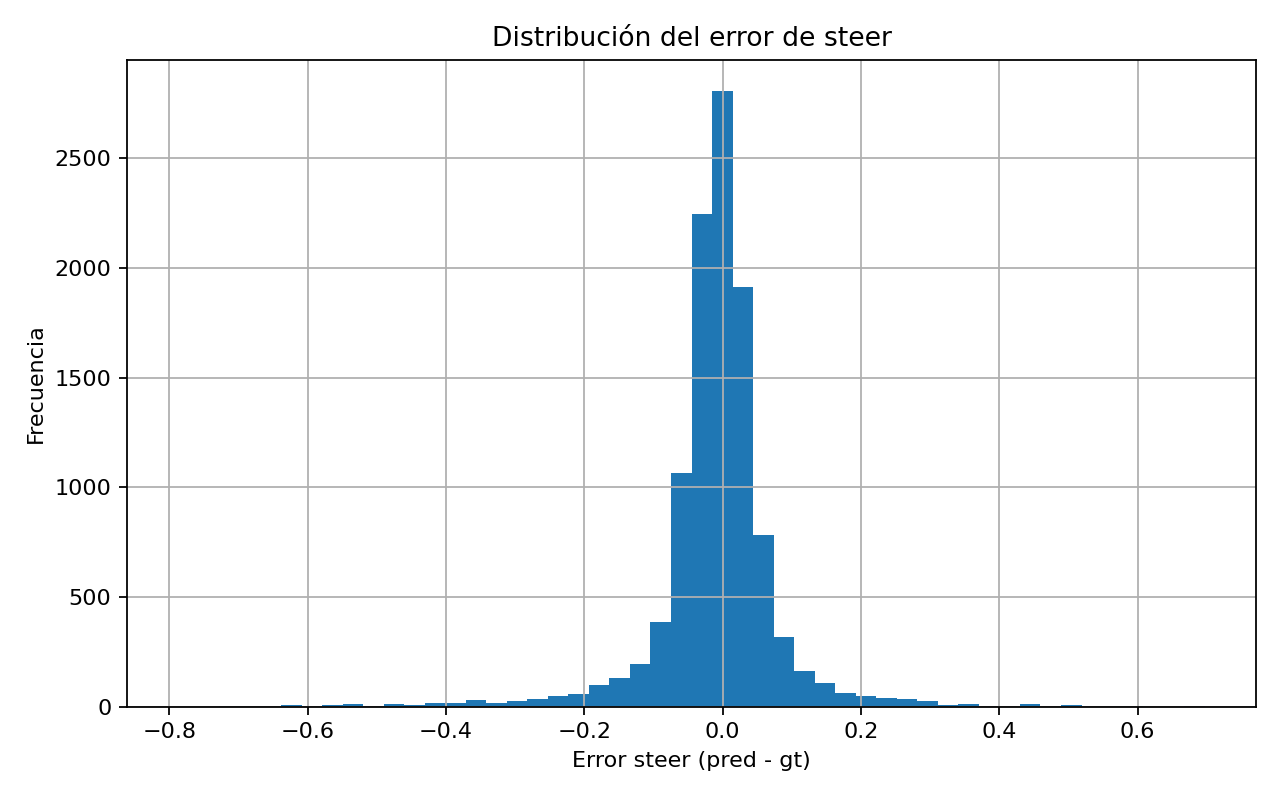
La distribución del error de steer se encuentra fuertemente concentrada alrededor de cero, indicando que la mayoría de las predicciones presentan errores pequeños. No obstante, aparecen colas hacia ambos extremos, asociadas principalmente a muestras con mayores valores de dirección. El MAE global obtenido fue aproximadamente 0.054, aunque el análisis por intensidad de giro mostró que el error aumenta considerablemente en curvas fuertes.
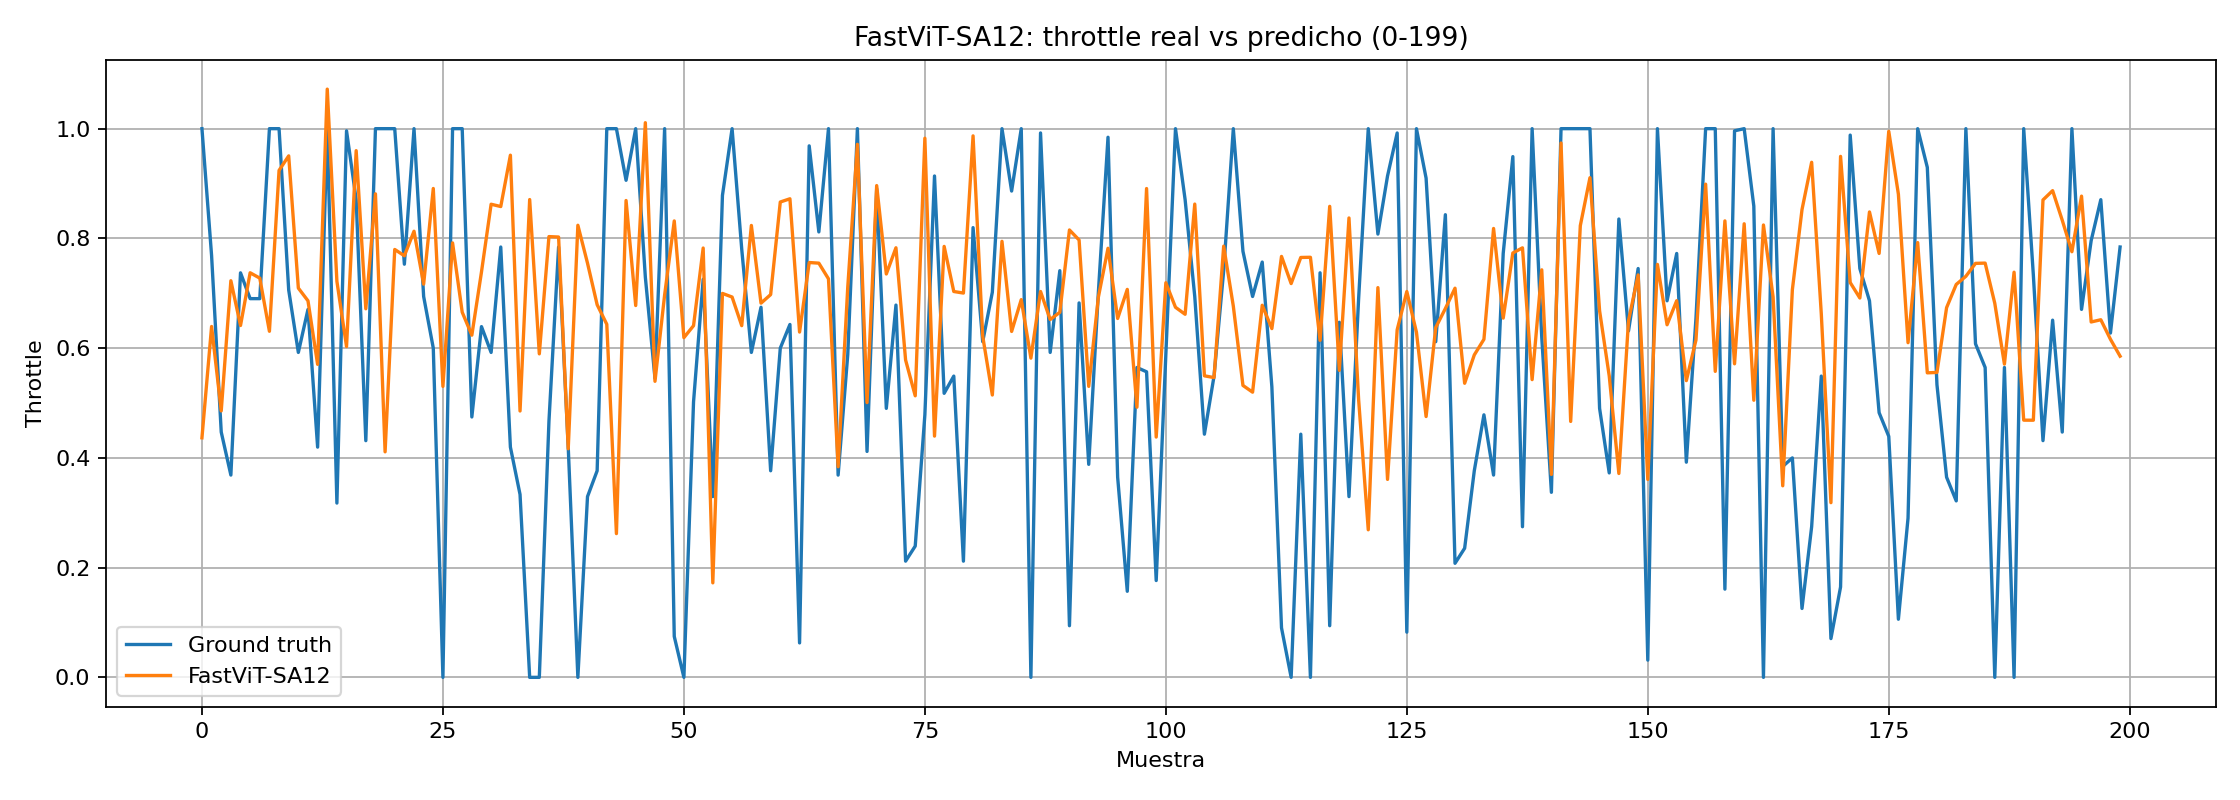
La predicción del throttle presenta un comportamiento menos satisfactorio. Mientras los valores reales varían ampliamente entre aceleraciones bajas y altas, las predicciones del modelo se concentran principalmente en valores intermedios. FastViT-SA12 no reproduce adecuadamente las variaciones rápidas del acelerador y tiende a suavizar tanto los valores bajos como los altos.
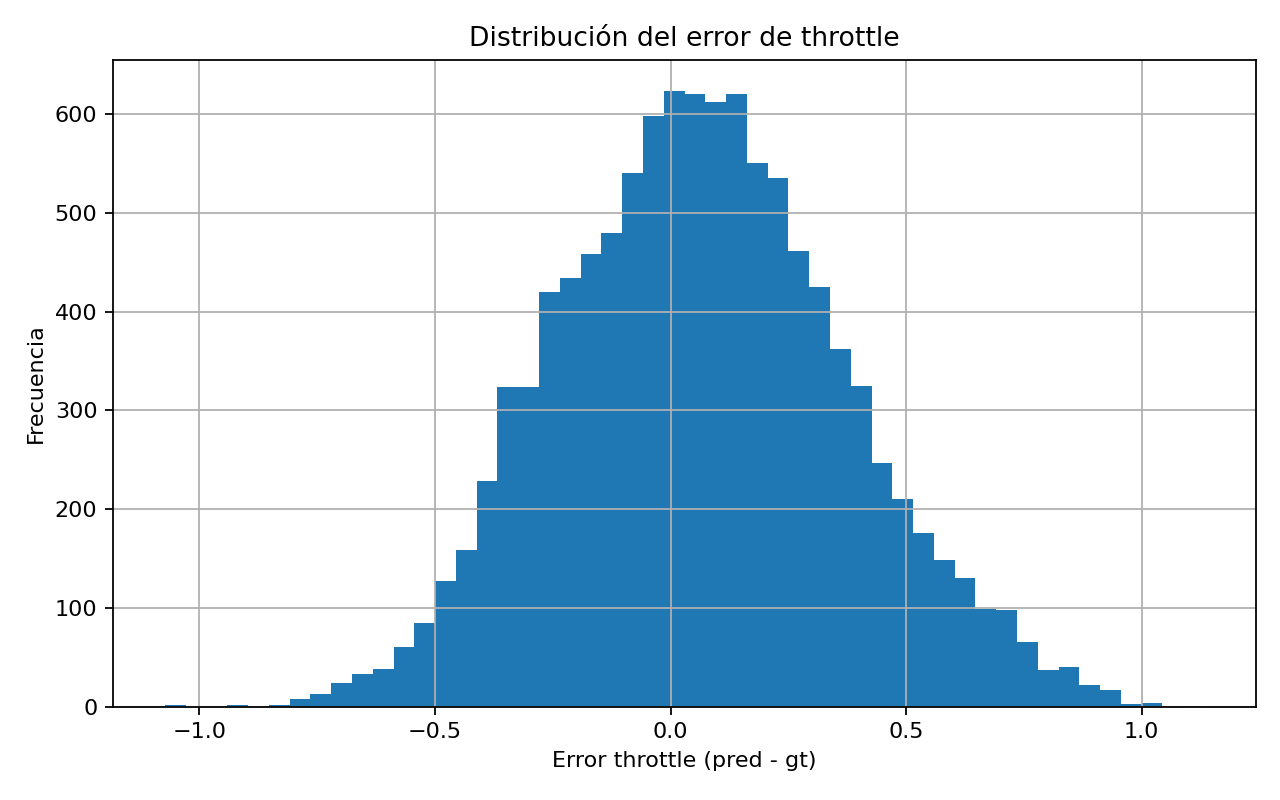
El histograma del throttle presenta una dispersión considerablemente mayor que el correspondiente al steer, confirmando la dificultad del modelo para estimar esta variable. El MAE obtenido fue aproximadamente 0.25, por lo que durante las pruebas online fue necesario restringir la salida del acelerador, utilizando valores máximos del orden de 0.5–0.6, para evitar aceleraciones excesivas y evaluar de manera más controlada el comportamiento de la dirección.
Observaciones de la prueba online
En las pruebas realizadas en CARLA, el vehículo logra navegar correctamente la mayor parte del circuito. Sin embargo, todavía se presentan fallos puntuales, principalmente durante algunas curvas y en la salida de estas. En determinadas situaciones la corrección de steer resulta insuficiente y el vehículo puede abandonar la trayectoria e impactar contra elementos del entorno, como postes.
Estos resultados muestran que el modelo entrenado únicamente con el dataset Burbuja proporciona una conducción nominal aceptable, pero todavía presenta limitaciones ante situaciones que requieren correcciones de dirección de mayor magnitud. Este comportamiento se utilizará como línea base para determinar posteriormente si las estrategias de enriquecimiento y mezcla de datasets mejoran la robustez de la conducción.