Día 7
Objetivo del día
Conseguir que el robot con cámara coja el cubo, lo levante y lo lleve al objetivo.
Recompensa por tenerlo agarrado en el aire
He añadido la recompensa grasped_in_air, que vale 1 cuando el cubo está agarrado con los dos dedos y no toca la mesa. Para saber si toca la mesa he puesto otro sensor de contacto (cubo–suelo), copiando el del choque de la pinza con el suelo:
def grasped_in_air(env, left_sensor_name, right_sensor_name, object_ground_sensor_name):
  grasped = finger_contact_grasp(env, left_sensor_name, right_sensor_name)
  ground = env.scene[object_ground_sensor_name]
  on_ground = (ground.data.found > 0).any(dim=-1)
  return grasped * (~on_ground).float()
Antes de entrenar comprobé que mide lo que quiero: con el robot sin cámara (que sí levanta el cubo) da 91 %, con el del día 6 da 0 % y moviéndose al azar da 0 %.
Experimentos con los pesos
Todos con 1024 entornos (~20 minutos por cada 1000 iteraciones):
| Pesos | Objetivo | Resultado |
|---|---|---|
grasped_in_air 1 |
20–40 cm | Casi nunca lo despega (en el aire el 0,1 % del tiempo) |
grasped_in_air 10 |
20–40 cm | Lo despega pero solo lo sube 2–3 cm, y entrenar más no lo mejora |
grasped_in_air 10 y lift 10 |
20–40 cm | Peor: casi nunca lo despega |
grasped_in_air 5 |
8–15 cm | Lo coge y lo lleva al objetivo: ~70 % de éxito |
- Con peso 1 el premio es demasiado raro y pequeño para notarse; con un peso alto sí lo aprende (Isaac Lab usa peso 15 en su tarea de levantar).
- Subir
liftno sirve porque mezcla acercarse al cubo y llevarlo al objetivo: estar al lado del cubo pasa a dar tanto como despegarlo. Lo importante es la relación entre los pesos, no lo grandes que sean. - Con el objetivo a 20–40 cm,
liftapenas cambia en los primeros centímetros; con el objetivo bajo, cada centímetro se nota.
En el que funcionó cambié dos cosas a la vez (objetivo y peso), así que repetí el entrenamiento con el objetivo bajo pero sin grasped_in_air (--env.rewards.grasped-in-air.weight 0.0): se queda en 0 % todo el entrenamiento, con el cubo en la mesa. grasped_in_air es imprescindible; bajar el objetivo ayuda, pero no basta.
Currículo de altura
Con el objetivo bajo funciona, pero la tarea original pide llevarlo a 20–40 cm. Primero lo subí a mano por tramos, continuando desde el último modelo, y después lo metí en la configuración como un currículo (como el que ya tenía la tarea para la penalización por velocidad), en src/tfg/mdp.py:
def target_height_curriculum(env, env_ids, command_name, stages):
  """Sube la altura del objetivo según la iteración del entrenamiento."""
  iteration = env.common_step_counter // 24  # 24 pasos por iteración

  height = stages[0][1]
  for start_iteration, stage_height in stages:
    if iteration >= start_iteration:
      height = stage_height

  command = env.command_manager.get_term(command_name)
  command.cfg.target_position_range.z = height
  return {"target_height_max": torch.tensor(height[1])}
Las etapas son (iteración de inicio, altura): 0 → 8–15 cm, 2000 → 12–20 cm, 2500 → 16–25 cm, 3000 → 20–30 cm y 3500 → 20–40 cm. Con 4500 iteraciones por defecto, el entrenamiento completo es un solo comando:
uv run train Tfg-Lift-Cube-Yam-Depth --env.scene.num-envs 1024 --agent.logger tensorboard
Quitar la recompensa de agarre del día 6
Probé el mismo entrenamiento quitando grasp (la que el robot engañaba en el día 6) y llega al mismo resultado, así que la eliminé. Las recompensas finales son lift, lift_precise y grasped_in_air, más las penalizaciones de la tarea original.
Resultado final
Entrenamiento desde cero con el currículo y sin grasp: 4500 iteraciones, 94 minutos, 2,4 GB de memoria de GPU y 71 °C como máximo. Evaluado con 512 robots y un intento de 20 s cada uno:
| Altura del objetivo | Éxito |
|---|---|
| 8–15 cm | 99 % |
| 15–20 cm | 99 % |
| 20–25 cm | 100 % |
| 25–30 cm | 100 % |
| 30–40 cm | 100 % |
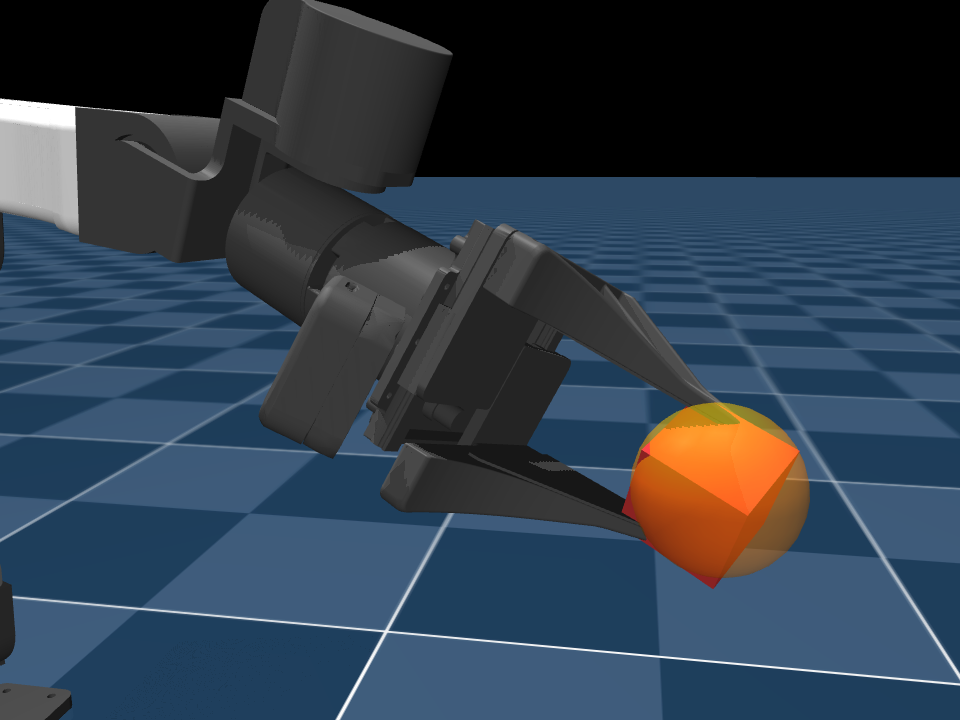
Tarea basada en el ejemplo Mjlab-Lift-Cube-Yam-Depth de mjlab (licencia Apache 2.0).
En el visor parece que a veces se le cae el cubo, pero casi siempre es que el cubo se teletransporta al cambiar el objetivo (cada 4 s en play). Medido sin cambios de objetivo, solo el 3,4 % de los robots tiene alguna caída real, y siempre lo vuelve a coger.
Conclusiones
- Con RL puro (PPO, el actor solo ve la cámara de profundidad) el brazo del ejemplo coge el cubo y lo lleva al objetivo, cuando la tarea original con cámara daba 0 %.
- La clave ha sido la recompensa por despegar el cubo agarrado (
grasped_in_air) y el currículo de altura del objetivo. - En cada paso el robot encontró una “solución cómoda” a medias (apoyar la pinza encima, despegarlo sin subirlo) y hubo que cambiar la recompensa para sacarlo de ahí.
- Limitaciones: brazo, cámara y cubo del ejemplo, solo en simulación y con pocas ejecuciones (habría que repetirlo con más semillas).
Próximos pasos
- Separar en el código el entrenamiento de la inferencia y hacer un programa que use el robot ya entrenado.
- Pick and place: coger el cubo y dejarlo en otro sitio.