Día 8
Objetivo del día
Separar el entrenamiento de la inferencia: hacer un programa que use la red ya entrenada (día 7) sin mjlab, solo con MuJoCo.
Entrenar e inferir
- Entrenar es lo que hacía con
uv run train: mjlab, PPO, muchos robots en paralelo y recompensas. El resultado es la red, que mjlab exporta en formato ONNX. - Inferir es usar esa red sin aprender nada más. Solo hace falta MuJoCo (la física), la red y un bucle que las conecte, igual que en un robot real.
La escena la exporté de mjlab con uv run export-scene Tfg-Lift-Cube-Yam-Depth, pero no incluía las mallas del brazo ni la física del entrenamiento así que las añadí al .xml.
Qué pide la red
| Forma | Contenido | |
|---|---|---|
Entrada obs |
26 números | posición de las articulaciones respecto al reposo (8), velocidades (8), acción anterior (7) y objetivo visto desde la pinza (3) |
Entrada camera |
32×32 | imagen de profundidad de la muñeca, recortada a 0,5 m y dividida entre 0,5 |
Salida actions |
7 números | una por motor (6 articulaciones y la pinza) |
La salida no es directamente la posición de los motores: mjlab la escala para que la red trabaje con números parecidos y cerca de 0, y la cuenta desde la postura de reposo. Así que el objetivo de cada motor es acción × escala + postura de reposo. La escala y la postura de reposo vienen guardadas dentro del .onnx.
El bucle
mientras el visor esté abierto:
    montar la observación y la imagen desde MuJoCo
    acción = red(observación, imagen)
    motores = acción × escala + reposo
    4 pasos de física (la red decide 50 veces por segundo, como al entrenar)
El problema de la cámara
Al principio el robot empujaba el cubo y se quedaba quieto. Comparando con mjlab desde el mismo estado, la observación era idéntica pero la imagen no: la cámara de la muñeca está definida como rectangular (1280×720) y, al hacer una foto cuadrada de 32×32, mjlab recorta el centro mientras que MuJoCo la estira. La red veía un ángulo distinto al del entrenamiento. Lo arreglé fijando el ángulo de visión de la cámara a 58°, el mismo que veía mjlab.
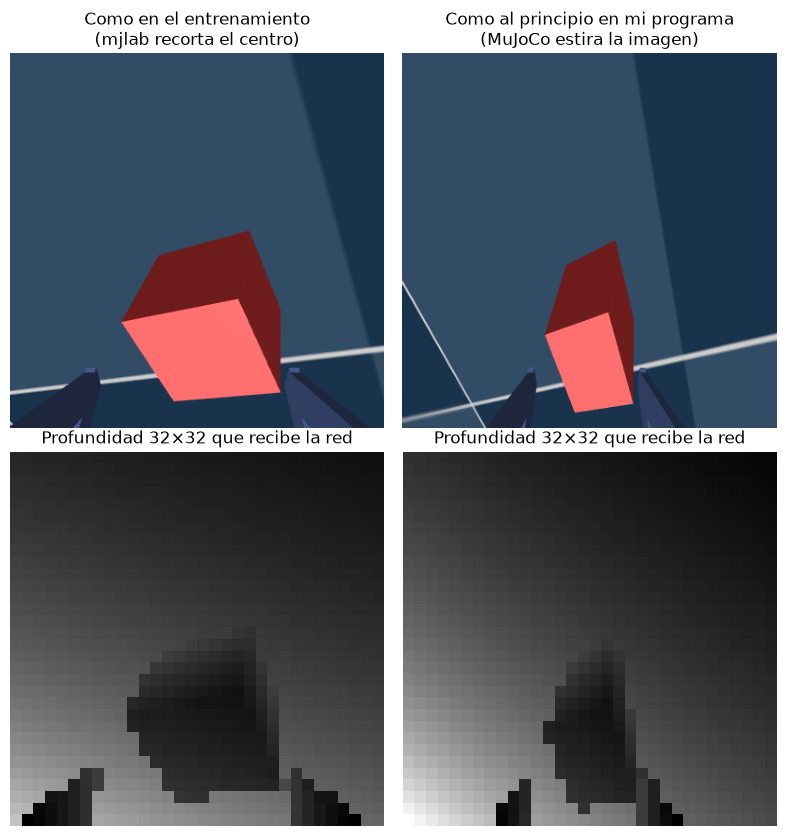
Izquierda: lo que veía la red al entrenar. Derecha: lo que le llegaba en mi programa antes del arreglo. Arriba en color, abajo la profundidad de 32×32 que recibe la red.
Resultado
Con el cubo en (0,30; 0; 0,02) m y el objetivo en (0,40; 0; 0,15) m, el robot coge el cubo y lo lleva a menos de 2 cm del objetivo en 1 segundo, igual que la misma red dentro de mjlab.
Conclusiones
- La inferencia funciona sin mjlab.
- Lo importante es que todo sea igual que en el entrenamiento: observaciones, cámara, física y frecuencia. Una diferencia pequeña en la cámara bastó para que fallara sin dar ningún error.
Próximos pasos
- Medir el éxito con muchas posiciones al azar del cubo y del objetivo.
- Pick and place: coger el cubo y dejarlo en otro sitio.